Τεχνητή νοημοσύνη: πιο έξυπνοι οργανισμοί, όχι μόνο πιο γρήγοροι
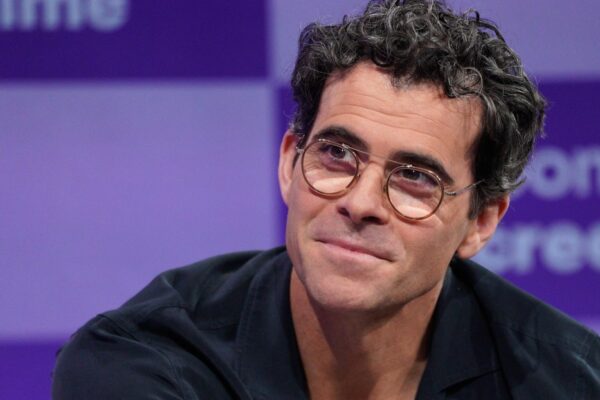
Ο Τιμ Ο’Ράιλι και ο Άντριου Οντεβάν συζήτησαν πώς ένας οργανισμός μπορεί να γίνει πιο «έξυπνος» με την τεχνητή νοημοσύνη, όχι μόνο πιο γρήγορος. Η συζήτηση έγινε στις 15 Οκτωβρίου 2026, στο πλαίσιο του Live with Tim O’Reilly, της ζωντανής σειράς συνεντεύξεων που μεταδίδεται στην πλατφόρμα μάθησης της O’Reilly.
Ο Άντριου Οντεβάν, CTO της O’Reilly Media, παρουσίασε ένα σύνολο εργαλείων που η εταιρεία αποκαλεί Expert Intelligence. Πρόκειται για ένα σύστημα που συνδέει έναν AI agent με τα εσωτερικά συστήματα ενός οργανισμού, του δίνει ένα skill file για το πώς να συλλογίζεται όσα βρίσκει και στηρίζει την ανάλυσή του στα πρακτικά πλαίσια της βιβλιοθήκης της O’Reilly.
Ο Οντεβάν είπε ότι η δουλειά ξεκίνησε από μια προσωπική ανάγκη. Ήθελε να γνωρίζει την κατάσταση ενός project, για παράδειγμα πόσο θα διαρκούσε μια μετάβαση από το RabbitMQ στο Pub/Sub. Όπως σημείωσε, αυτό είναι το είδος ερώτησης που κάθε μηχανικός φοβάται, αλλά κάθε επικεφαλής μηχανικής καλείται να απαντήσει. Παράλληλα, τον απασχολούσε και κάτι ευρύτερο: το να είναι ένα άτομο καλό στην τεχνητή νοημοσύνη δεν σημαίνει ότι είναι και ολόκληρος ο οργανισμός.
Για να χτίσει τον ερευνητικό agent, ακολούθησε τέσσερα βήματα. Χαρτογράφησε τα πληροφοριακά συστήματα του οργανισμού ως ιεραρχία, τα συνέδεσε μέσω MCP, έγραψε ένα skill που περιγράφει πώς να τα χρησιμοποιεί και στη συνέχεια πρόσθεσε το επίπεδο Expert Intelligence.
Καθοριστικό ρόλο έπαιξε η χαρτογράφηση των πηγών αλήθειας στις ροές εργασίας της ομάδας μηχανικής. Ο Οντεβάν εξήγησε πώς συνδέονται μεταξύ τους: οι στρατηγικοί στόχοι και οι προτεραιότητες των λειτουργιών βρίσκονται στο Productboard, από εκεί περνούν σε epics, sprints και stories στο Jira, και τα stories γίνονται κώδικας στο GitHub. Ένα service catalog περιγράφει περίπου 300 υπηρεσίες που αποτελούν την πλατφόρμα της O’Reilly και ποιος είναι υπεύθυνος για καθεμία, ενώ τα εργαλεία observability δείχνουν πώς αποδίδουν αυτές οι υπηρεσίες σε σχέση με τα SLOs τους.
Το skill έπρεπε επίσης να αποτυπώσει τοπικές ιδιαιτερότητες. Κάποιες ομάδες θεωρούν ένα epic ολοκληρωμένο με μια ημερομηνία λήξης, ενώ άλλες το κλείνουν μόνο όταν έχουν κλείσει όλα τα tickets. Ο Οντεβάν έδωσε επίσης εντολή στον agent να λειτουργεί ως ερευνητικός agent και όχι ως coding agent, με αποστολή να γράφει αναφορές.
Η σύνδεση όλων μέσω MCP ήταν, όπως είπε, «το πιο βαρετό βήμα όλης της διαδικασίας». Την περίοδο εκείνη το Productboard δεν διέθετε MCP server, οπότε ο ίδιος έγραψε ένα wrapper. Αργότερα, όταν ο Τιμ Ο’Ράιλι ρώτησε πώς θα μπορούσε μια άλλη εταιρεία να επαναλάβει τη διαδικασία με διαφορετικά εργαλεία, ο Οντεβάν πρότεινε να ξεκινήσει από τη λίστα των προμηθευτών. Να εξαχθεί από το procurement system, να ζητηθεί από το μοντέλο ποια προϊόντα παράγουν αυτοί οι προμηθευτές και ποια κρατούν πληροφορίες σχετικές με τα ερωτήματα που ενδιαφέρουν την εταιρεία, και να μπουν σε σειρά. Οι product managers της O’Reilly μετατρέπουν τώρα αυτή τη διαδικασία σε skill για το επερχόμενο Expert Intelligence Skills Hub.
Ένα μέλος του κοινού ρώτησε αν το MCP είναι πράγματι το σωστό εργαλείο για εσωτερική γνώση σε σύγκριση με το semantic search. Ο Οντεβάν απάντησε ότι μερικές φορές οτιδήποτε είναι καλύτερο από το τίποτα. Τελικά, όπως είπε, αυτό που θέλεις είναι να δώσεις στο μοντέλο τη δυνατότητα να αναζητά σε όλα τα συστήματά σου.
Κεντρικό μέρος της παρουσίασης ήταν η σύγκριση πριν και μετά σε μια συγκεκριμένη περίπτωση χρήσης που ο Οντεβάν είχε περιγράψει παλαιότερα στο άρθρο του «Building Organizational Intelligence». Ένας engineering manager του ζήτησε να προσλάβει έναν ακόμη μηχανικό και ο ίδιος έβαλε τον reporting and analysis agent να τεκμηριώσει την ανάγκη. Η πρώτη αναφορά κάλυπτε την ομάδα των πέντε ατόμων που διαχειρίζεται περιεχόμενο και metadata, τις 10 υπηρεσίες tier-A που κατέχει, μαζί με τις υπηρεσίες B και C, την κατάσταση της μετάβασης στο Pub/Sub, που είχε ολοκληρωθεί κατά 64%, και το πλήρες backlog. Το συμπέρασμα ήταν ότι η ομάδα είχε πρόβλημα χωρητικότητας και πιθανότατα έπρεπε να προσλάβει. Ο Οντεβάν το χαρακτήρισε χρήσιμο και πολύ λεπτομερές, αλλά ίσως υπερβολικά λεπτομερές.
Στη συνέχεια συνέδεσε τον agent με το Expert Intelligence, του ζήτησε να λειτουργήσει σαν σύμβουλος και επανέλαβε την ανάλυση. Η νέα αναφορά κατέληξε σε πολύ διαφορετικό συμπέρασμα. Ξεκινούσε λέγοντας ότι το πρόβλημα λειτουργικού βάρους της ομάδας ήταν «δομικό, όχι έλλειψη στελέχωσης». Όταν χρησιμοποίησε το Expert Intelligence, ο agent έφερε μέσα την έννοια του toil από το Google’s Site Reliability Workbook. Toil είναι η χειρωνακτική, επαναλαμβανόμενη, αυτοματοποιήσιμη λειτουργική εργασία που αυξάνεται γραμμικά με μια υπηρεσία. Ο reporting and analysis agent χρησιμοποίησε αυτή την έννοια για να διαχωρίσει το backlog της ομάδας σε toil και σε δουλειά που τα μέλη ήθελαν πραγματικά να κάνουν. Πρότεινε έναν οργανωμένο toil audit πριν από τον επόμενο κύκλο σχεδιασμού, έναν ρητό στόχο μείωσης του toil και τη διαχείριση της ευθύνης των runbooks ως βασικού στοιχείου μηχανικής. Ο Οντεβάν είπε ότι η ομάδα ακολούθησε τις συστάσεις και έκλεισε σημαντικό μέρος ενός backlog που είχε αρχίσει να λειτουργεί ως γνωστικό βάρος για όλους.
Η αναφορά επικαλέστηκε επίσης τον Jim Highsmith, συνυπογράφοντα το Agile Manifesto και συγγραφέα του Wild West to Agile, για να υποστηρίξει ότι το τεχνικό χρέος της ομάδας αυξανόταν σωρευτικά. Ο Οντεβάν εξήγησε τη διαφορά από τη συνηθισμένη συμβουλή διοίκησης με ένα παράδειγμα:
«Πολλές φορές, όταν διαβάζεις τέτοια υψηλού επιπέδου πλαίσια, είναι σαν να τρως το μπρόκολο σου. Ξέρω ότι πρέπει να το κάνω. Αλλά αυτό που έκανε αυτό πραγματικά ενδιαφέρον ήταν ότι ανέδειξε ένα συγκεκριμένο project που είχαμε, το Django upgrade, και το έβαλε μέσα σε αυτό το ευρύτερο πλαίσιο. Δεν ήταν απλώς “ορίστε μια αφηρημένη αρχή που θα έπρεπε να εφαρμόζεις”. Ήταν “ορίστε το backlog σου και ορίστε ένα συγκεκριμένο παράδειγμα”».
Μια δεύτερη ανάλυση εξέτασε υπηρεσίες που διέσχιζαν τα όρια μεταξύ ομάδων. Με βάση ειδικούς στα microservices και το έργο του Kent Beck για τη σύζευξη, το οποίο παραπέμπει στο Tidy First?, το σύστημα κατέληξε ότι το video metadata service ήταν πρόβλημα περίπλοκου υποσυστήματος και όχι πρόβλημα ορίων. Σε αυτή την εκδοχή, ο Οντεβάν έκανε τον agent να εξάγει αποσπάσματα, να τα αποδίδει σωστά και να παραπέμπει στο πρωτότυπο κείμενο. Η ανάλυση αποδείχθηκε ιδιαίτερα αποτελεσματική. Η εταιρεία έχει από τότε αποσύρει μερικά συστήματα. «Δεν θέλω τα LLMs να προσθέτουν κώδικα», είπε ο Οντεβάν. «Θέλω να τον μειώνουν».
Ο Οντεβάν ανέφερε ότι αυτό που τον εξέπληξε περισσότερο ήταν η αντίδραση των συναδέλφων του. Οι προηγούμενες αναφορές του ήταν απλώς dumps δεδομένων. Οι αναγνώστες δεν μπορούσαν να καταλάβουν από πού προερχόταν κάθε ισχυρισμός και, γι’ αυτό, δεν ήταν τόσο αξιοποιήσιμες. Όταν όμως η ανάλυση παρέπεμπε σε ειδικούς που οι μηχανικοί γνώριζαν από τη δική τους δουλειά, τα έγγραφα έγιναν, όπως είπε, «πολύ πιο προσιτά, πολύ πιο ανθρώπινα», και ο κόσμος ασχολήθηκε μαζί τους πολύ βαθύτερα.
Ο Τιμ Ο’Ράιλι έδωσε στο σημείο αυτό το ευρύτερο πλαίσιο. Ανέφερε ότι η εικόνα πως τα μοντέλα είναι πια αρκετά έξυπνα ώστε να τους λες απλώς τι να κάνουν και να τα αφήνεις να λειτουργούν μόνα τους, είναι μια άποψη που ακούγεται συχνά από τους vibe coders και όσους μιλούν για «dark factories». Ο ίδιος υποστήριξε αντίθετα την επιστροφή στην τεχνογνωσία.
Έφερε ως παράδειγμα ανάρτηση που δημοσιεύτηκε εκείνη την ημέρα από τον Felix Rieseberg της Anthropic, με τίτλο «How to Be More Ambitious: A Tutorial for Humans with Models», όπου περιγράφονται τέσσερα είδη φιλοδοξίας όταν δουλεύει κανείς με μοντέλα: ταχύτητα, ύψος, βάθος και εύρος. Οι περισσότερες συζητήσεις για την οικονομική αξία της τεχνητής νοημοσύνης αφορούν την ταχύτητα, δηλαδή το ίδιο έργο σε λιγότερο χρόνο. Στην ανάγνωση του Ο’Ράιλι, ο Οντεβάν κέρδισε ύψος, επειδή σκέφτηκε το αποτέλεσμα και όχι μόνο τις επιμέρους εργασίες, και βάθος, επειδή προσέγγισε το πρόβλημα όπως θα το έκανε ένας κορυφαίος ειδικός του πεδίου, απλώς επικαλούμενος τους ειδικούς.
Ο Ο’Ράιλι χρησιμοποίησε και μια μεταφορά που αναπτύσσει εδώ και καιρό για τον προγραμματισμό με τεχνητή νοημοσύνη ως μια μορφή μαγικής επίκλησης. Στα κόμικς και τις ταινίες της Marvel, ο Doctor Strange ανοίγει τα ξόρκια του επικαλούμενος κάποια πηγή, με φράσεις όπως «by the power of the dread Dormammu» ή «by the hoary hosts of Hoggoth». Ο Οντεβάν, είπε, έκανε κάτι αντίστοιχο, σαν να έλεγε: «Με τη δύναμη του Kent Beck, θέλω να σκεφτείς διαφορετικά αυτό το πρόβλημα». Ακόμη και όταν δεν αναφερόταν ρητά σε κάποιον ειδικό, όπως με το SRE workbook, το να στρέφει το μοντέλο στην τεχνογνωσία που έχει αποτυπωθεί στο εκδοτικό σώμα της O’Reilly ανέβαζε τον πήχη του αποτελέσματος.
Ο Ο’Ράιλι περιέγραψε αυτό το σχήμα ως χρήση της ανθρώπινης εμπειρίας σαν μηχανισμό εστίασης και το συνέδεσε με τη θέση του ότι τα LLMs πρέπει να αντιμετωπίζονται περισσότερο ως μέσο με το οποίο δημιουργούμε παρά ως αυτόνομες νοημοσύνες. Παράλληλα, αντέτεινε στην ιδέα, που συχνά συνδέεται με το «The Bitter Lesson», ότι τα μοντέλα θα βελτιώνονται απλώς από μόνα τους και η ανθρώπινη τεχνογνωσία θα πάψει να έχει σημασία. Ο Οντεβάν, είπε, βρήκε έναν συγκεκριμένο τρόπο με τον οποίο η τεχνογνωσία εξακολουθεί να μετρά.
Ο ίδιος ο Οντεβάν πήρε τη μεταφορά και την προχώρησε. Το πρώτο του prompt, είπε, ήταν «Be snobby. Go find these great resources and look at them». Θέλει να δίνει στο μοντέλο κανoνικά έργα ενός πεδίου, όπως το Designing Data-Intensive Applications, και να του λέει «αυτοί είναι οι τρόποι με τους οποίους θέλω να σκέφτεσαι», αντί να δέχεται απλώς ό,τι παράγει πρώτο το μοντέλο. Το παρομοίασε με τη σχολή διοίκησης επιχειρήσεων, όπου μεγάλο μέρος όσων μαθαίνεις είναι ένα σύνολο πλαισίων για να οργανώνεις τα δεδομένα.
Ο Ο’Ράιλι υποστήριξε ακόμη ότι τα μοντέλα δεν αποδίδουν καλύτερα χωρίς καθοδήγηση. Όπως είπε, αν παρακολουθήσει κανείς την αλληλουχία σκέψης τους όταν ψάχνουν πληροφορίες, μπορεί να σταματήσουν σε κάποιο τυχαίο αρχείο από το διαδίκτυο αντί για κανoνικές πηγές. Ακόμη και με ένα frontier model όπως το Fable, η δική του εμπειρία ήταν ότι το μοντέλο συχνά κάνει λάθος πρώτες κινήσεις και προσπαθεί να φτάσει στη λύση με ωμή δύναμη, όχι απαραίτητα γνωρίζοντας από την αρχή πώς να προσεγγίσει το πρόβλημα.
Ο Οντεβάν ανέφερε ένα πρόσφατο παράδειγμα, όταν ζήτησε από τον agent να εξετάσει σχέδια κινήτρων για τις ομάδες μηχανικής και προϊόντος. Η πρώτη απάντηση ήταν ότι, σύμφωνα με την εταιρεία Robusto, αυτό είναι το πλαίσιο που πρέπει να ακολουθηθεί. Ο ίδιος, όπως είπε, αναρωτήθηκε τι είναι η Robusto και γιατί το βλέπει. Κατάλαβε τότε ότι δεν ήταν συνδεδεμένος στο VPN. Μόλις το ενεργοποίησε, η απάντηση άλλαξε σε αναφορά στο Harvard Business Review και στις διαφορετικές προσεγγίσεις σχεδιασμού τέτοιων προγραμμάτων.
Ο Ο’Ράιλι έθεσε και μια οικονομική διάσταση. Αναφέρθηκε σε οδηγίες μέσα στο system prompt του Claude της Anthropic που περιορίζουν το πόσο μπορεί να παραθέτει το μοντέλο από κάθε πηγή και το ερμήνευσε ως ένδειξη ότι οι εταιρείες τεχνητής νοημοσύνης θέλουν να αποφύγουν την πληρωμή για περιεχόμενο. Κατά την άποψή του, το αποτέλεσμα είναι ότι τα μοντέλα δεν μπορούν να αξιοποιούν αρκετά συγκεκριμένα το καλύτερο υλικό που έχουν στη διάθεσή τους και καταφεύγουν συχνά σε γενικότητες. Το χαρακτήρισε ως μια πρώιμη μορφή enshittification στην τεχνητή νοημοσύνη.
Η O’Reilly ακολουθεί την αντίθετη κατεύθυνση. Ο Οντεβάν εξήγησε ότι η εταιρεία εφαρμόζει το μοντέλο δικαιωμάτων που χρησιμοποιεί ήδη για το O’Reilly Answers. Το υλικό που επιστρέφεται μέσω του Expert MCP server μπορεί να παρατεθεί και οι συγγραφείς αμείβονται με δικαιώματα χρήσης, ώστε η εξειδικευμένη γνώση να έχει αγορά και απόδοση.
Σε απάντηση ερώτησης από το κοινό, ο Ο’Ράιλι και ο Οντεβάν είπαν ότι το Expert Intelligence βρίσκεται σε prerelease με μια ομάδα founding partners, καθώς η O’Reilly εξετάζει ακόμη την οικονομική του δομή. Οι οργανισμοί που ενδιαφέρονται μπορούν να ζητήσουν πρόσβαση.
Πηγή: oreilly.com.
Το κείμενο δημιουργήθηκε από GPT 5.0. Δείτε τα AI Editorial Guidelines.
Σχετικά άρθρα
Από ταμειακές μηχανές σε δανειολήπτες: οι δαπάνες για AI έφτασαν στην αγορά ομολόγων
Η Wikipedia προειδοποιεί: αυστηρή απόφαση για τα δικαιώματα στην ΤΝ απειλεί τον ανοιχτό ιστό